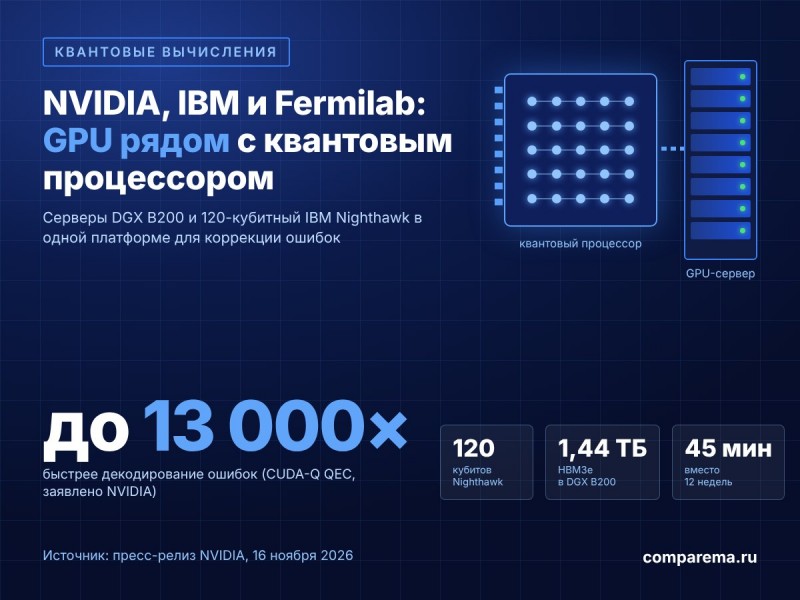
16 ноября 2026 года, к открытию конференции по суперкомпьютерам SC26 в Чикаго, NVIDIA, IBM и Национальная ускорительная лаборатория имени Ферми (Fermilab, Министерство энергетики США) объявили о платформе совместного проектирования модульных квантовых компьютеров. Рядом с квантовыми компьютерами IBM, включая системы на процессоре IBM Quantum Nighthawk (120 кубитов), будут установлены серверы NVIDIA DGX B200 — по восемь GPU Blackwell и 1,44 ТБ памяти HBM3e в каждом. Задача платформы — коды коррекции ошибок, алгоритмы декодирования и гибридные квантово-классические приложения для физики высоких энергий и ядерной физики. Отдельно NVIDIA выпустила декодер TCBP-JOBS в библиотеке CUDA-Q QEC 0.9.0: по заявлению компании, он ускоряет самые тяжёлые расчёты в исследованиях коррекции ошибок до 13 000 раз — в одном из примеров время расчёта сократилось с 12 недель до 45 минут.
Что именно объявили: платформа, декодер и планировщик
Анонс состоит из трёх частей, и важно не смешивать их. Первая — сама платформа: IBM и NVIDIA разместят серверы DGX B200 рядом с квантовыми компьютерами IBM, в том числе на процессоре Nighthawk, который NVIDIA называет самым быстрым квантовым процессором IBM. Fermilab через свой центр SQMS (Superconducting Quantum Materials and Systems, один из пяти национальных центров квантовой науки Министерства энергетики США) задаёт требования со стороны физики: какие коды коррекции и какие гибридные приложения нужны для задач физики высоких энергий и ядерной физики. Отдельная цель — изучить, как несколько квантовых процессоров работают вместе в модульной архитектуре и как классические вычисления масштабируются рядом с ними. Площадка, бюджет и сроки запуска в пресс-релизе не названы, а директор SQMS Анна Грасселлино в своей цитате говорит о «предлагаемой платформе».
Вторая часть — декодер TCBP-JOBS. В квантовом компьютере с коррекцией ошибок кубиты постоянно измеряются, а классический компьютер по результатам измерений («синдромам») должен быстро вычислить, какая ошибка произошла и как её исправить. Это и есть декодирование, и оно должно успевать за циклом коррекции, который у сверхпроводящих кубитов составляет порядка микросекунды. TCBP-JOBS — алгоритм для GPU, доступный в открытой библиотеке CUDA-Q QEC 0.9.0; NVIDIA утверждает, что на исследовательских нагрузках он до 13 000 раз быстрее существующих ведущих алгоритмов при сохранении точности. Это ускорение исследований (перебора конструкций кодов и архитектур), а не заявление о готовом декодере реального времени.
Третья часть — планировщик. NVIDIA расширяет открытый менеджер нагрузок Slurm квантовым интерфейсом, а IBM добавляет к нему свой Quantum Resource Management Interface. Суперкомпьютерные центры смогут ставить задачи на квантовые процессоры так же, как на CPU и GPU, — в общей очереди. Заодно NVIDIA напомнила о работе IBM и RIKEN: на квантовых компьютерах IBM и GPU-суперкомпьютере ROQUO рассчитаны энергии связывания белково-лигандных комплексов размером до 12 635 атомов — более чем в 40 раз больше предыдущего квантово-классического рекорда в 303 атома; работа вышла в финал премии ACM Gordon Bell Prize 2026.
Почему это важно: квантовый компьютер — это на 99% классический компьютер
Главная мысль анонса — не в кубитах, а в том, что вокруг них. Чтобы 120 физических кубитов Nighthawk превратить в несколько надёжных логических, нужны тысячи измерений в секунду, декодирование каждого синдрома и обратная связь быстрее, чем кубиты потеряют состояние. Всё это делает классическое «железо», и его нужно много: отсюда DGX B200 с 64 ТБ/с пропускной способности памяти прямо рядом с криостатом, а не в облаке за сотни километров. Та же логика у японского ROQUO (540 GPU Blackwell) и у платформы IBM с AMD и Окриджской лабораторией, объявленной 5 ноября: во всех трёх случаях квантовый процессор один и тот же — Nighthawk или его предшественник Heron, — а соревнуются поставщики GPU.
Что в этом хорошего:
- Коррекция ошибок переходит из теории в инженерию: три независимые площадки (NVIDIA, AMD, RIKEN) проверяют одни и те же коды на одном и том же процессоре IBM — результаты можно будет сравнивать.
- Открытые инструменты: CUDA-Q QEC и квантовый интерфейс Slurm публикуются как открытый код, ими смогут пользоваться университеты и лаборатории с любыми GPU NVIDIA, не только владельцы DGX.
- Ускорение исследований до 13 000 раз, если подтвердится на других задачах, означает, что перебор конструкций кодов и архитектур модульных машин станет делом дней, а не кварталов.
- Для покупателей серверов это сигнал: спрос на GPU-узлы с большой памятью растёт не только из-за ИИ, но и из-за квантовых программ государств и корпораций.
Что плохого или неясного:
- Платформа пока «предлагаемая»: нет даты запуска, площадки и бюджета. Это декларация намерений, подписанная тремя сторонами, а не действующая установка.
- 13 000 раз — цифра NVIDIA для исследовательских нагрузок, без названия алгоритмов, с которыми сравнивали, и без независимой проверки. Пример «12 недель → 45 минут» — один конкретный случай.
- Nighthawk — процессор без коррекции ошибок: 120 физических кубитов, а не логических. Отказоустойчивую систему IBM Quantum Starling IBM обещает только к 2029 году.
- Полезного для бизнеса результата — «квантового преимущества» на практической задаче — пока не продемонстрировал никто, включая IBM, которая ставит эту цель на конец 2026 года.
Характеристики платформы и её составляющих
| Параметр | Значение | Источник | Статус |
|---|---|---|---|
| Участники | NVIDIA, IBM, Fermilab (центр SQMS, Министерство энергетики США) | пресс-релиз NVIDIA | подтверждено |
| Классическая часть | NVIDIA DGX B200: 8 GPU Blackwell, 1 440 ГБ HBM3e, 64 ТБ/с, 2 × Intel Xeon Platinum 8570 (112 ядер), 2 ТБ системной памяти, до 14,3 кВт | пресс-релиз NVIDIA; спецификация DGX B200 | подтверждено |
| Производительность DGX B200 | 72 ПФЛОПС FP8 (144 ПФЛОПС FP4) с разреженностью; NVLink 14,4 ТБ/с между GPU | спецификация NVIDIA | подтверждено |
| Квантовый процессор | IBM Quantum Nighthawk: 120 сверхпроводящих кубитов в квадратной решётке, 218 настраиваемых связей, каждый кубит связан с четырьмя соседями | IBM, 12 ноября 2025 года | подтверждено |
| Nighthawk r2 (текущая ревизия) | более 100 000 схем в секунду (в 25 раз больше Heron), точная оценка наблюдаемых на схемах с более чем 7 500 двухкубитными операциями | IBM, 9 сентября 2026 года | подтверждено |
| Направления работ | коды коррекции ошибок, алгоритмы декодирования, гибридные приложения для физики высоких энергий и ядерной физики; связка нескольких квантовых процессоров | пресс-релиз NVIDIA | подтверждено |
| Декодер TCBP-JOBS | в составе CUDA-Q QEC 0.9.0; до 13 000 раз быстрее существующих ведущих алгоритмов на исследовательских нагрузках; 12 недель → 45 минут в примере | пресс-релиз NVIDIA | заявлено NVIDIA |
| Планировщик | квантовый интерфейс для Slurm (NVIDIA) + Quantum Resource Management Interface (IBM) | пресс-релиз NVIDIA | подтверждено |
| Площадка и сроки | не названы; Fermilab говорит о «предлагаемой платформе» | пресс-релиз NVIDIA | не объявлено |
| Цена | не объявлена; стоимость DGX B200 NVIDIA публично не публикует | — | — |
Источники: пресс-релиз NVIDIA (16 ноября 2026 года); спецификация NVIDIA DGX B200 (данные производителя); анонс Nighthawk на IBM Quantum Developer Conference (Tom’s Hardware, heise, 12 ноября 2025 года); Nighthawk r2 (GCN, NAND Research, 9 сентября 2026 года).
Три гибридные платформы на процессорах IBM: NVIDIA, AMD и RIKEN
За полтора месяца IBM стала квантовой частью сразу трёх квантово-классических установок с разными поставщиками GPU. Сравнение показывает, что классическая часть у всех на порядок крупнее и дороже квантовой.
| Параметр | IBM + NVIDIA + Fermilab | IBM + AMD + ORNL | RIKEN ROQUO + IBM |
|---|---|---|---|
| Дата анонса | 16 ноября 2026 года | 5 ноября 2026 года | работает с 24 июня 2026 года |
| GPU | NVIDIA DGX B200: 8 × Blackwell на узел | AMD Instinct MI355X + EPYC 5-го поколения (система Umbra) | 540 × NVIDIA Blackwell (135 узлов GB200 NVL4, 270 CPU Grace) |
| Память GPU | 180 ГБ HBM3e на GPU, 1 440 ГБ на узел, 64 ТБ/с | 288 ГБ HBM3e на GPU, 8 ТБ/с; 2 304 ГБ на 8-GPU узел | HBM3e Blackwell + LPDDR5X Grace; 19,8 ПФЛОПС FP64 (HPL) |
| Сеть | InfiniBand/Ethernet 400 Гбит/с (ConnectX-7) | не раскрыта | NVIDIA Quantum-X800 InfiniBand до 3,2 Тбит/с |
| Квантовый процессор | IBM Nighthawk (120 кубитов) и другие системы IBM | IBM Nighthawk r2 (120 кубитов), доступ на уровне импульсов | IBM Heron (ibm_kobe), Quantinuum Reimei (ионная ловушка) |
| Площадка | не названа | IBM, Покипси (штат Нью-Йорк) | RIKEN R-CCS, Кобе (Япония) |
| Главная задача | коррекция ошибок, декодеры, физика высоких энергий, модульность | коррекция ошибок, иерархические коды, путь к Starling (2029) | квантовая химия, материалы; рекорд 12 635 атомов |
| Статус | «предлагаемая платформа» | запущена | в эксплуатации |
Источники: пресс-релиз NVIDIA (16 ноября 2026 года); IBM Newsroom, The Next Platform и Quantum Computing Report о платформе с AMD и ORNL (5–6 ноября 2026 года); RIKEN R-CCS, TechRepublic и Quantum Computing Report о ROQUO (24 июня и 22 июля 2026 года); спецификации DGX B200 (NVIDIA) и Instinct MI355X (AMD). Зелёным выделены лучшие значения. Оговорка: платформы разного масштаба и назначения — ROQUO это полноценный суперкомпьютер на 540 GPU, а две другие — исследовательские стенды из нескольких узлов; число узлов DGX B200 и MI355X в пресс-релизах не названо.
Объём памяти — по спецификациям производителей (B200 в составе DGX B200: 1 440 ГБ на 8 GPU). Число кубитов — максимум для симуляции полного вектора состояния в формате complex64 на одном ускорителе, расчёт КомпаРЕМА по формуле ниже, без учёта рабочих буферов симулятора.
Сколько памяти GPU нужно для симуляции квантовой схемы: формула и таблица
Эта часть пригодится независимо от судьбы платформы. Большая часть «квантовых» вычислений сегодня выполняется на обычных GPU: разработчики алгоритмов, студенты и исследователи декодеров запускают схемы в симуляторах (NVIDIA cuQuantum и CUDA-Q, Qiskit Aer), а на настоящий квантовый процессор выходят в самом конце. Самый точный метод — симуляция полного вектора состояния — требует хранить все 2 в степени N амплитуд, и память растёт вдвое с каждым кубитом.
Память (байт) = 2 в степени N × 8 (complex64) или × 16 (complex128), где N — число кубитов
Каждый добавленный кубит удваивает потребность в памяти, поэтому разница между 30 и 40 кубитами — тысяча раз. Именно поэтому для симуляций берут ускорители с максимальной памятью на карту, а не с максимальными ФЛОПС: производительность упирается в пропускную способность памяти, как и при инференсе языковых моделей.
| Кубитов | Память, complex64 | Память, complex128 | Что подходит (complex64) |
|---|---|---|---|
| 24 | 134 МБ | 268 МБ | любая видеокарта, даже CPU |
| 28 | 2,1 ГБ | 4,3 ГБ | любая видеокарта от 8 ГБ |
| 30 | 8,6 ГБ | 17,2 ГБ | от 16 ГБ: RTX 5080, A30 (complex128 — 24 ГБ) |
| 31 | 17,2 ГБ | 34,4 ГБ | 24–32 ГБ: RTX 5090, A30, RTX 4500 Ada |
| 32 | 34,4 ГБ | 68,7 ГБ | 48 ГБ: L40S, RTX PRO 5000 Blackwell, A40 |
| 33 | 68,7 ГБ | 137 ГБ | 96 ГБ: RTX PRO 6000 Blackwell |
| 34 | 137 ГБ | 275 ГБ | 180–288 ГБ: B200, MI355X; или 2 × RTX PRO 6000 с распределением вектора |
| 36 | 550 ГБ | 1,1 ТБ | сервер с 8 × RTX PRO 6000 (768 ГБ) |
| 37 | 1,1 ТБ | 2,2 ТБ | узел DGX B200 (1 440 ГБ) или 8 × MI355X (2 304 ГБ) |
| 40 | 8,8 ТБ | 17,6 ТБ | кластер из 8 узлов DGX B200 с InfiniBand |
Расчёт КомпаРЕМА по формуле выше: объём самого вектора состояния без рабочих буферов. На практике симуляторам нужен запас 10–50% памяти под промежуточные данные, поэтому на границе (например, 33 кубита на 96 ГБ) схема может не поместиться — закладывайте на один кубит меньше. При распределении вектора на несколько GPU скорость определяет шина между ними (NVLink или PCIe) и сеть между узлами.
Хронология
Что это значит для покупателей в России
Серверы DGX B200 в Россию официально не поставляются, а по параллельному импорту приходят единичными экземплярами по цене, которую имеет смысл обсуждать только под конкретный проект. Но для 90% практических квантовых задач — обучения, разработки алгоритмов, симуляции схем в CUDA-Q и Qiskit, исследований декодеров — DGX не нужен: CUDA-Q и cuQuantum работают на любом ускорителе NVIDIA, а главный параметр, как показывает таблица выше, — объём памяти на карту. Карта на 96 ГБ закрывает 33 кубита, сервер с восемью такими картами — 36, и это уже уровень университетских лабораторий. В наличии у нас:
- NVIDIA RTX PRO 6000 Blackwell Server Edition 96 ГБ GDDR7, пассивное охлаждение, 600 Вт — для серверов: 33 кубита на одной карте, 36 на восьми; тот же Blackwell, что и в DGX B200.
- NVIDIA RTX PRO 6000 Blackwell Workstation Edition 96 ГБ — та же память в рабочей станции исследователя: симуляция до 33 кубитов и обучение моделей на столе.
- NVIDIA L40S 48 ГБ GDDR6, PCIe 4.0 — проверенный серверный ускоритель для 32 кубитов, инференса и виртуальных рабочих станций.
- NVIDIA RTX PRO 5000 Blackwell 48 ГБ GDDR7 ECC, 300 Вт — 32 кубита при вдвое меньшей мощности, чем у RTX PRO 6000; для рабочих станций и компактных серверов.
- NVIDIA A30 24 ГБ HBM2, 165 Вт — недорогой ускоритель с полноценным FP64 для научных расчётов и 31 кубита в complex64; ставится по 4–8 штук в сервер.
- Palit GeForce RTX 5090 32 ГБ GDDR7 — для учебного класса или разработчика: 31 кубит и Blackwell по цене игровой карты, без ECC и серверной поддержки.
- Платформа Gooxi AS4110G-D10R-G3, 4U на 10 GPU, 4 × 2 200 Вт — шасси под 8–10 ускорителей RTX PRO 6000 или L40S: до 960 ГБ памяти GPU в одном узле.
- Коммутатор NVIDIA Quantum-2 MQM9790, 64 × 400G InfiniBand — для кластера из нескольких GPU-узлов, когда вектор состояния не помещается в один сервер.
Соберём GPU-сервер для симуляции квантовых схем и ИИ
Напишите, сколько кубитов нужно симулировать или какие модели обучать, — подберём ускорители с нужным объёмом памяти, платформу с достаточным питанием и охлаждением и подготовим КП для юрлица с НДС. Работаем с университетами, НИИ и ИТ-компаниями.
Запросить КП на zakaz@comparema.ruВопросы и ответы
Что такое платформа совместного проектирования (codesign) квантовых компьютеров?
Что такое IBM Quantum Nighthawk и сколько у него кубитов?
Что делает декодер TCBP-JOBS и правда ли он в 13 000 раз быстрее?
Сколько памяти GPU нужно для симуляции квантовой схемы на N кубитов?
Можно ли работать с CUDA-Q и cuQuantum без DGX B200?
Что купить сейчас для квантовых симуляций и ИИ-задач?