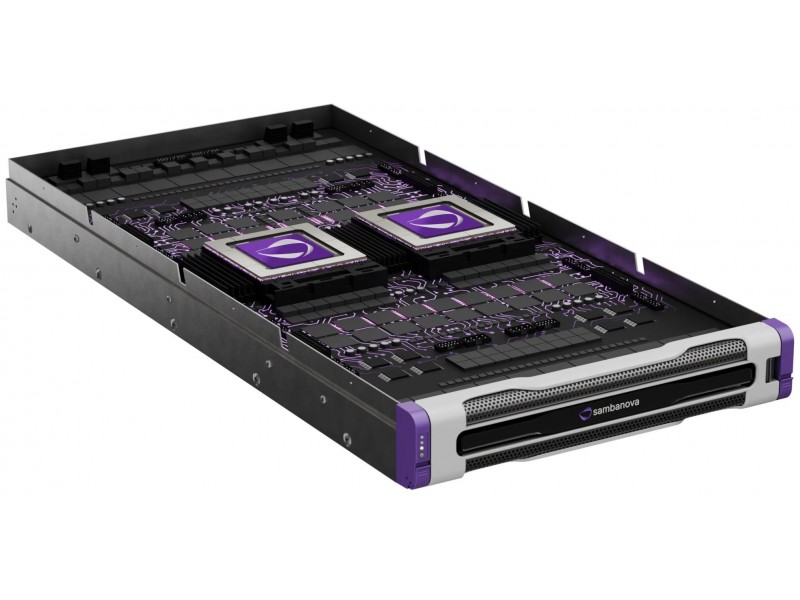
Supermicro и SambaNova объявили о стратегическом сотрудничестве по созданию серверных систем для ИИ-инференса. Первоначальный план предусматривает закупку 10 000 ускорителей SambaNova SN50 RDU. Новая архитектура рассчитана на совместное использование двух типов вычислительных устройств: GPU Nvidia обрабатывают входные запросы и выполняют этап предварительной обработки данных — prefill, а ускорители SambaNova SN50 RDU выполняют генерацию ответа — decode, когда модель последовательно формирует токены. Такое разделение нагрузки называется disaggregated inference — раздельная организация этапов инференса.
Что именно объявили Supermicro и SambaNova
Сотрудничество строится вокруг disaggregated inference — раздельной организации этапов инференса. В традиционной схеме один ускоритель выполняет всю цепочку: принимает входной запрос, обрабатывает его и генерирует ответ токен за токеном. В новой архитектуре эти этапы разделены между разными устройствами.
GPU Nvidia выполняют prefill — предварительную обработку входного запроса, когда модель «читает» весь контекст и строит внутренние представления. Ускорители SambaNova SN50 RDU выполняют decode — последовательную генерацию ответа, когда модель выдаёт токены один за другим. По замыслу разработчиков, это позволяет распределять вычисления между специализированными устройствами, не заставляя один тип ускорителя выполнять все операции.
Supermicro будет интегрировать оборудование, проверять готовые системы, поставлять их заказчикам и обеспечивать техническую поддержку. Первые решения планируется предлагать облачным провайдерам, включая Neoclouds и суверенные облака, а затем корпоративным клиентам.
Как работает раздельный инференс
| Этап | Устройство | Что происходит |
|---|---|---|
| Prefill | GPU Nvidia | обработка входного запроса и построение внутренних представлений |
| Decode | SambaNova SN50 RDU | последовательная генерация токенов ответа |
| Интеграция | Supermicro | сборка, проверка, поставка и поддержка систем |
| Первые заказчики | облачные провайдеры | Neoclouds и суверенные облака, затем корпоративные клиенты |
Почему это важно для ИИ-агентов
Для работы ИИ-агентов недостаточно быстро обработать запрос пользователя. Модель может многократно обращаться к инструментам, базам данных и другим программам, после чего снова генерировать ответ. Каждый такой цикл — это чередование prefill и decode, и нагрузка на каждом этапе различается.
Разделение prefill и decode позволяет подбирать оборудование под особенности каждого этапа. Это потенциально улучшает использование вычислительных ресурсов и снижает стоимость инференса. Вместо того чтобы покупать универсальные ускорители «на все случаи», можно комбинировать специализированные устройства под конкретный профиль нагрузки.
- Prefill хорошо распараллеливается и требует высокой пропускной способности памяти — с этим справляются GPU.
- Decode чувствителен к задержкам и требует эффективной генерации токенов — здесь могут выигрывать специализированные RDU.
- Разделение позволяет масштабировать каждый этап независимо, не переплачивая за универсальность.
Ограничения и риски
- План на 10 000 ускорителей — это намерение, а не гарантия. Объёмы поставок и сроки могут корректироваться.
- Раздельный инференс требует сложной оркестрации. Нужно программное обеспечение, которое умеет передавать данные между prefill- и decode-устройствами без потери производительности.
- Привязка к двум экосистемам. Заказчик получает связку GPU Nvidia и ускорителей SambaNova, что усложняет поддержку и совместимость.
- Незрелость рынка. Disaggregated inference пока не стал массовой практикой; независимых тестов и отраслевых стандартов немного.
- Экономика. Выгода от разделения этапов зависит от конкретной модели, нагрузки и соотношения цен на GPU и RDU.
Что это значит для рынка
Сотрудничество Supermicro и SambaNova — пример движения к гетерогенным ИИ-системам. Вместо одной универсальной платформы заказчик получает комбинацию устройств, каждое из которых оптимизировано под свой этап инференса. Если подход подтвердится на реальных нагрузках, это может изменить структуру закупок: вместо «ещё нескольких GPU-стоек» заказчики будут считать баланс между prefill- и decode-мощностями.
Для производителей это также сигнал: конкуренция идёт не только за пиковую производительность ускорителей, но и за эффективность на конкретных этапах инференса. Специализированные RDU могут найти нишу рядом с GPU, а не вместо них.
Что это значит для покупателей в России
Официальных поставок Supermicro и Nvidia в Россию нет, но их продукция доступна через параллельный импорт. Однако гибридные системы с ускорителями SambaNova SN50 RDU — это новое направление, которое пока только выходит на рынок. В ближайшее время в российских ЦОД такие конфигурации вряд ли появятся: они требуют сервисной поддержки, совместимого программного обеспечения и отлаженной логистики.
Практический вывод: при закупке ИИ-систем стоит учитывать не только наличие ускорителей, но и программную совместимость и поддержку используемых моделей. Для типовых задач — 1С, виртуализации, СУБД, хранения и небольшого инференса — по-прежнему достаточно серверов с локальной DDR5, которые есть на складе.
- HPE ProLiant DL380 Gen12 8SFF (P89316-425-001-000) — шасси 2U под Xeon 6 и DDR5: основа для сборки под конкретную задачу.
- HPE ProLiant DL360 Gen12 8SFF MR408i-o (P89233-425-001-000) — то же поколение в 1U для плотной установки.
- HPE ProLiant DL380 Gen11 Xeon Silver 4410Y, 32 ГБ DDR5, 12 LFF (P52562-B21) — готовая конфигурация для 1С и виртуализации.
- SSD HPE 7,68 ТБ NVMe Read Intensive (P40567-B21) — для баз данных и наборов данных под ИИ.
Соберём сервер под 1С, виртуализацию, хранение или инференс, подберём память DDR5, диски и сетевые карты. Для юридических лиц подготовим коммерческое предложение и счёт.
Запросить КП на zakaz@comparema.ru