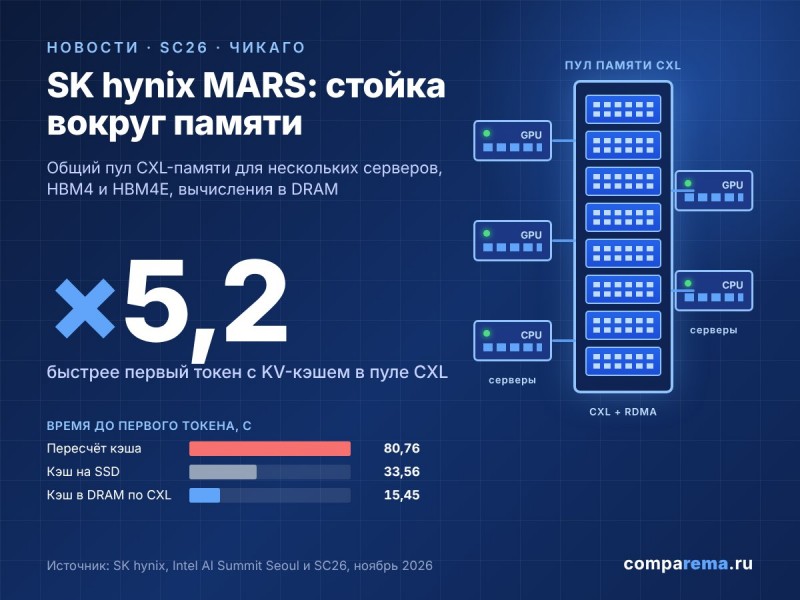
На конференции Supercomputing 2026 (SC26, Чикаго, 15–20 ноября 2026 года) SK hynix показала в работе стойку MARS — Memory-centric AI Rack System. Это серверная стойка, в которой центральное место занимает не процессор и не GPU, а общая инфраструктура памяти: пул CXL-модулей, к которому обращаются сразу несколько серверов, гибридная память из DRAM и SSD для хранения KV-кэша и вычисления прямо внутри DRAM. Главная цифра пришла неделей раньше, 12 ноября, с Intel AI Summit в Сеуле: в тесте SK hynix с партнёрами многошаговый диалог с ИИ-моделью начинал отвечать через 15,45 секунды, когда KV-кэш брался из удалённого пула CXL-памяти, против 80,76 секунды при пересчёте с нуля — в 5,2 раза быстрее. Рядом компания выставила HBM4, образцы HBM4E на 48 ГБ, модули DDR5 RDIMM на 256 ГБ и SSD с жидкостным охлаждением. Цен и сроков у MARS нет: это концепция, которую SK hynix проверяет с Intel и SK Telecom.
Что такое MARS и что показали на SC26
SK hynix называет MARS стойкой нового поколения, в которой решения партнёров собраны в один шкаф, а в центре стоит память. Стойка впервые была показана на OCP Global Summit в Сан-Хосе 12–15 октября 2026 года, а на SC26 компания привезла три рабочих демонстрации. Ни для одной из них SK hynix не опубликовала цифр, поэтому ниже — только то, что показано.
| Демонстрация | Что показано | Зачем |
|---|---|---|
| Общий KV-кэш уровня стойки | CXL-память объединена с гибридной памятью CXL (DRAM плюс SSD). KV-кэш лежит на SSD внутри гибридного модуля; система по истории диалога предсказывает, какие фрагменты понадобятся, и заранее поднимает их в DRAM | Хранить большой объём кэша дёшево и читать быстро |
| Обслуживание ИИ-агентов через вычислительный пул памяти | Несколько серверов и GPU подключены к общему пулу на базе CXL. KV-кэш избирательно передаётся и переиспользуется через пул, а не пересылается по обычной сети | Убрать повторные вычисления и сетевые задержки между узлами |
| Обмен токенами через пул CXL | CPU-серверы делятся через пул входными данными и уже сгенерированными токенами для мультимодальных сервисов | Не повторять предобработку и сократить простой GPU |
| KV Cache Offloading over CXL | В иерархию HBM — DRAM добавлен пул CXL. Кэш, который понадобится скоро, остаётся в HBM и DRAM, остальное уходит в пул; решение принимается по частоте и давности обращений, размеру и стоимости восстановления. Проверено с SK Telecom в реальной среде вывода LLM | Третий уровень памяти для KV-кэша без потери скорости отклика |
| Compute-using-DRAM | Вычисления выполняются внутри массива ячеек DRAM за счёт разделения заряда: одновременно активируются тысячи и десятки тысяч бит, строки копируются и сравниваются параллельно, наружу передаётся только результат. Отдельного вычислительного блока нет, используется серийная DRAM | Поднять полосу и энергоэффективность без потери ёмкости |
| Custom HBM Array (cHBM) | Несколько кастомных HBM с вычислительными функциями соединяются между собой; вычисления и память ставятся друг над другом, чтобы сократить путь данных | Снять ограничение на число HBM, которые GPU может подключить |
Источник: пресс-центр SK hynix, 20 ноября 2026 года. На SC26 компания также провела доклад «Enabling Agentic AI Serving with Disaggregated Memory Pools» об общем KV-кэше и обмене токенами между CPU-стойками.
Откуда взялись 80,76 и 15,45 секунды
Цифры прозвучали не на SC26, а 12 ноября 2026 года на Intel AI Summit Seoul, где вице-президент SK hynix Чу Ён Пхё (Joo Young-pyo) представил архитектуру «стойки памяти». Идея та же, что у MARS: рядом со стойками GPU- и CPU-серверов ставится отдельная стойка с десятками или сотнями терабайт памяти, к которой серверы обращаются по CXL и RDMA. Когда у GPU заканчивается место под KV-кэш, кэш не стирается, а переезжает в пул; при следующем обращении пользователя он возвращается оттуда, а не пересчитывается заново.
В тесте SK hynix с партнёрами сравнили три варианта для многошагового диалога. Среднее время до первого токена: 80,76 секунды при стирании и пересчёте кэша, 33,56 секунды при хранении кэша на внешнем SSD и 15,45 секунды при хранении в удалённой DRAM по CXL. Сокращение — около 81%, или в 5,2 раза. SK hynix заявила, что будет проверять архитектуру вместе с Intel, заказчиками и партнёрами, начиная со стадии проектирования систем.
Источники: ChosunBiz, EconoTimes, Dataconomy, TokenPost, 12–13 ноября 2026 года. Это результат одного сценария с длинным контекстом, выбранного SK hynix; модель, длина диалога и конфигурация серверов не раскрыты. Пересчёт кэша как базовый вариант — худший случай; на коротких диалогах разница будет меньше.
Почему это важно
Современные ИИ-системы всё чаще упираются не в вычислительную мощность GPU, а в объём и скорость доступа к данным. У каждого ускорителя есть собственная HBM, но её объём фиксирован: 80–288 ГБ на карту в текущих поколениях. ИИ-агенты и длинные диалоги раздувают KV-кэш до десятков гигабайт на одного пользователя, и когда HBM заканчивается, кэш приходится либо стирать и считать заново, либо выгружать на SSD. Первое тратит GPU-время, второе — медленно. Пул памяти, общий для нескольких серверов, добавляет третий уровень между HBM и SSD и позволяет использовать серверную DRAM эффективнее: память не простаивает в тех узлах, которым она сейчас не нужна.
Для SK hynix это ещё и смена роли: из поставщика микросхем компания становится архитектором систем. Та же логика у Samsung, которая на OCP показала пул памяти CXL вместе с AMD (подробнее — в нашей новости о тесте Samsung и AMD), и у Microsoft с Intel, которые заявили память CXL одним из направлений своего долгосрочного соглашения.
Что хорошего:
- KV-кэш, которого не хватает в HBM, перестаёт пересчитываться: это экономит GPU-часы и сокращает время ответа на длинных диалогах.
- Пул наращивается отдельно от серверов: не нужно менять платформу, чтобы добавить память.
- Для CPU-нагрузок (предобработка, RAG, векторный поиск) общий пул убирает дублирование данных между узлами.
- Модули CMM-DDR5 второго поколения на 256 ГБ по CXL 3.2 — уже реальное железо, показанное на HPE Discover, OCP и SC26.
Что плохого:
- MARS — концепция без цен и сроков. Три демонстрации на SC26 показаны без цифр.
- Удалённая CXL-память в 2–5 раз медленнее локальной DRAM по задержке; выигрыш есть только там, где альтернатива — пересчёт или SSD.
- Нужны процессоры с CXL (Xeon 6, EPYC 9005 и новее), поддержка в BIOS, CXL-коммутаторы для пула и программный слой, который решает, что и куда выгружать.
- Цифра 5,2 раза получена самим производителем на одном сценарии и с базовым вариантом в виде полного пересчёта.
MARS в цифрах и фактах
| Параметр | Значение | Статус |
|---|---|---|
| Что это | Стойка с общей инфраструктурой памяти для ИИ-серверов: пул CXL-памяти, гибридная память DRAM плюс SSD, Compute-using-DRAM, Custom HBM Array | концепция |
| Где показана | OCP Global Summit, Сан-Хосе, 12–15 октября 2026 года; Intel AI Summit Seoul, 12 ноября 2026 года; SC26, Чикаго, 15–20 ноября 2026 года | показано |
| Модули пула | CMM-DDR5 2-го поколения: 256 ГБ, CXL 3.2, до 80 ГБ/с, примерно на 30% энергоэффективнее 1-го поколения (128 ГБ, CXL 2.0, PCIe 5.0 x8) | заявлено производителем |
| Ёмкость стойки памяти | Десятки — сотни терабайт | заявлено на Intel AI Summit |
| Подключение серверов | CXL и RDMA; несколько серверов и GPU обращаются к одному пулу | заявлено |
| Что хранит | KV-кэш LLM, входные данные и токены мультимодальных сервисов | показано на SC26 |
| Результат теста | Время до первого токена 15,45 с против 80,76 с при пересчёте и 33,56 с с внешним SSD | тест SK hynix с партнёрами |
| Партнёры | SK Telecom — проверка KV Cache Offloading в реальной среде; Intel — проверка архитектуры со стадии проектирования | названы |
| Память рядом | HBM4 (12 слоёв, 36 ГБ, 2048 бит, более 10 Гбит/с), образцы HBM4E (48 ГБ, 16 Гбит/с), RDIMM DDR5 на 256 ГБ (3DS), MRDIMM 128 ГБ, SOCAMM 192 ГБ, SSD PEB210 E1.S с жидкостным охлаждением, PS1110 E3.S, PS1010 U.2 | показано |
| Цена | Не объявлена; стойка как продукт не анонсирована | — |
Источники: пресс-центр SK hynix (20 ноября 2026 года); The Asia Business Daily, TokenPost, StorageReview — OCP 2026; BigGo Finance, ChosunBiz — Intel AI Summit Seoul; Korea Times, HPCwire — HBM4E; SK hynix — HBM4.
Кто ещё строит пулы памяти CXL: SK hynix, Samsung, Micron
Все три крупнейших производителя DRAM выпускают модули CXL, но пулы памяти на их основе пока показывают только двое. Ниже — модули и заявленные результаты. Базовые варианты в тестах разные, поэтому проценты между SK hynix и Samsung напрямую не сравниваются.
| Параметр | SK hynix CMM-DDR5 (2-е пок.) | Samsung CMM-D MD310 | Micron CZ122 | Для сравнения: DDR5-6400 RDIMM |
|---|---|---|---|---|
| Ёмкость модуля | 256 ГБ | 256 ГБ | 128 / 256 ГБ | до 128 ГБ массово, 256 ГБ (3DS) |
| Интерфейс | CXL 3.2 | CXL 3.2, PCIe 6.0 | CXL 2.0, PCIe 5.0 x8 | канал DDR5 процессора |
| Полоса модуля | до 80 ГБ/с | до 72 ГБ/с (отраслевые публикации) | 37 ГБ/с | 51,2 ГБ/с на канал |
| Форм-фактор | E3.S | E3.S | E3.S 2T | DIMM |
| Демонстрация пула | MARS: TTFT 15,45 с против 80,76 с при пересчёте (в 5,2 раза) | С AMD на OCP 2026: TTFT ниже до 38%, полезная пропускная способность до 3,3 раза против статического распределения | Пул не показан; модули сертифицированы с Intel и AMD | — |
| Статус | Показан на HPE Discover, OCP, SC26 в 2026 году | Поставляется (по данным StorageReview) | Поставляется, сертифицирован для RHEL | В продаже |
Источники: The Asia Business Daily и TokenPost (SK hynix, 16 октября и 13 ноября 2026 года); StorageReview (Samsung и AMD, октябрь 2026 года); каталог Red Hat и материалы Micron (CZ120/CZ122); отраслевой обзор рынка CXL (полоса MD310 — не подтверждена Samsung). Зелёным выделены лучшие значения. Цифры тестов SK hynix и Samsung — результаты самих производителей.
Уровни памяти ИИ-сервера: где место пулу CXL
Чтобы понять, что даёт MARS, полезно расставить все виды памяти по полосе и задержке. Пул CXL встаёт между локальной DRAM и SSD: он в сотни раз быстрее твердотельного накопителя по задержке, но в несколько раз медленнее памяти в слотах сервера.
| Уровень | Полоса | Задержка | Ёмкость на устройство | Что хранить |
|---|---|---|---|---|
| HBM3E (один стек) | около 1,2 ТБ/с | на корпусе GPU | 36 ГБ (12 слоёв) | Веса модели, активный KV-кэш |
| HBM4 (один стек) | более 2,5 ТБ/с | на корпусе GPU | 36 ГБ (12 слоёв), 48 ГБ (16 слоёв) | Веса модели, активный KV-кэш |
| DDR5-6400 RDIMM (канал) | 51,2 ГБ/с | 80–140 нс | 32–128 ГБ на модуль | Выгруженный KV-кэш, данные CPU |
| Локальный модуль CXL | 37–80 ГБ/с | 170–250 нс | 128–256 ГБ | Расширение DRAM сверх слотов |
| Пул CXL через коммутатор | зависит от топологии | около 600 нс (прототип SK hynix Niagara) | десятки ТБ на стойку | Общий KV-кэш нескольких серверов |
| NVMe SSD (PCIe 5.0) | до 14 ГБ/с | около 100 000 нс (100 мкс) | до 122 ТБ | Холодный KV-кэш, контрольные точки |
Источники: SK hynix — HBM3E и HBM4 (расчёт полосы: 2048 бит × 10 Гбит/с / 8 = 2,56 ТБ/с); JEDEC — DDR5-6400 (64 бит × 6400 МТ/с / 8 = 51,2 ГБ/с); arXiv 2607.18141 «A CXL Memory Rack for Multi-Turn LLM Serving» — задержки локальной DRAM, CXL-модулей и пула Niagara; Micron, SK hynix — полоса CXL-модулей. Задержка NVMe — типичное значение для чтения 4 КБ.
Сколько памяти занимает KV-кэш: формула и таблица для популярных моделей
Эта часть пригодится независимо от новостей — при любом расчёте сервера под локальную LLM. KV-кэш хранит ключи и значения внимания для каждого токена контекста и растёт линейно с длиной диалога. Его размер на один токен считается по параметрам модели.
КБ на токен = 2 × слои × KV-голов × размер головы × байт на число / 1024
Для моделей с группированным вниманием (GQA) число KV-голов меньше числа голов внимания, поэтому кэш заметно компактнее, чем у старых архитектур. DeepSeek V3 и R1 используют сжатие MLA: вместо отдельных ключей и значений на каждую голову хранится один сжатый вектор на слой. Таблица рассчитана для 16-битного кэша (FP16/BF16); при FP8 значения вдвое меньше.
| Модель | Слои × KV-голов × размер головы | КБ на токен | Контекст 32 тыс. токенов | Контекст 128 тыс. токенов |
|---|---|---|---|---|
| Llama 3.1 8B | 32 × 8 × 128 | 128 | 4 ГБ | 16 ГБ |
| Llama 3.1 70B, Qwen2.5-72B | 80 × 8 × 128 | 320 | 10 ГБ | 40 ГБ |
| Mistral Large 2 (123B) | 88 × 8 × 128 | 352 | 11 ГБ | 44 ГБ |
| Qwen3-235B-A22B | 94 × 4 × 128 | 188 | 5,9 ГБ | 23,5 ГБ |
| Llama 3.1 405B | 126 × 8 × 128 | 504 | 15,8 ГБ | 63 ГБ |
| DeepSeek V3 / R1 (MLA) | 61 слой × 576 чисел | 68,6 | 2,1 ГБ | 8,6 ГБ |
Расчёт КомпаРЕМА по открытым конфигурациям моделей (файлы config.json на Hugging Face). Пример: Llama 3.1 70B — 2 × 80 × 8 × 128 × 2 байта = 327 680 байт = 320 КБ на токен; 320 КБ × 131 072 токена = 40 ГБ. Для DeepSeek — 61 слой × 576 чисел (512 сжатых плюс 64 позиционных) × 2 байта = 70 272 байта. Объёмы в гибибайтах, округлены.
Сколько памяти нужно под веса модели
| Размер модели | FP16 / BF16 (2 байта) | FP8 / INT8 (1 байт) | INT4 (0,5 байта) | Что подходит |
|---|---|---|---|---|
| 8 млрд параметров | 16 ГБ | 8 ГБ | 4 ГБ | одна карта 24–48 ГБ |
| 32 млрд | 64 ГБ | 32 ГБ | 16 ГБ | одна карта 48–96 ГБ |
| 70–72 млрд | 140 ГБ | 70 ГБ | 35 ГБ | одна карта 96 ГБ в INT4 или две по 48 ГБ |
| 123 млрд | 246 ГБ | 123 ГБ | 62 ГБ | две карты по 96 ГБ |
| 235 млрд (MoE) | 470 ГБ | 235 ГБ | 118 ГБ | четыре карты по 96 ГБ в FP8 |
| 405 млрд | 810 ГБ | 405 ГБ | 203 ГБ | 8 карт по 96 ГБ в FP8 |
| 671 млрд (DeepSeek V3, MoE) | 1342 ГБ | 671 ГБ | 336 ГБ | 8 карт по 96 ГБ в FP8 (без запаса под кэш) |
Расчёт КомпаРЕМА: параметры × байт на параметр. К весам нужно прибавить KV-кэш из таблицы выше и 10–20% запаса на служебные буферы. Для моделей MoE в память загружаются все эксперты, хотя на каждом токене работает часть из них.
Хронология
Что это значит для покупателей в России
Стойки памяти и CXL-коммутаторы для пула — техника гиперскейлеров, в Россию она в обозримое время не попадёт, а серверные CXL-модули на 128–256 ГБ появляются у поставщиков штучно. Но сама задача, которую решает MARS, — куда деть KV-кэш, когда HBM кончилась, — стоит перед любой компанией, которая разворачивает локальную LLM для сотрудников или клиентов. Решение доступно и без CXL: больше DDR5 в сервере с GPU и быстрые NVMe для выгрузки кэша. Ориентиры из таблиц выше: на один диалог модели 70B с контекстом 32 тысячи токенов нужно 10 ГБ, с контекстом 128 тысяч — 40 ГБ; сервер с 1 ТБ оперативной памяти вмещает кэш десятков пользователей. Платформы на Xeon 6 и EPYC 9004/9005 дают 24–32 слота DDR5 на два сокета, а Xeon 6 и EPYC 9005 поддерживают CXL 2.0, так что при появлении модулей память можно будет нарастить без замены сервера.
В наличии у нас:
- SK hynix 64 ГБ DDR5 RDIMM ECC 2Rx4 HMCG94CKBRA437N — память производителя MARS: 16 модулей на два сокета дают 1 ТБ под выгруженный KV-кэш.
- Samsung 128 ГБ DDR5-6400 RDIMM M321RAJA0MB2-CCP — для 2 ТБ на двухсокетной платформе по одному модулю на канал, без потери скорости.
- Samsung 96 ГБ DDR5-6400 RDIMM M321RYGA0PB2-CCPKF — промежуточный объём: 1,5 ТБ из 16 модулей.
- Micron 64 ГБ DDR5-6400 RDIMM MTC40F2046S1RC64BR — альтернатива для платформ, где нужны модули из списка совместимости Micron.
- NVIDIA RTX PRO 6000 Blackwell Server Edition 96 ГБ GDDR7 — одна карта вмещает модель 70B в INT4 вместе с кэшем одного диалога на 128 тысяч токенов.
- NVIDIA L40S 48 ГБ GDDR6 — для моделей до 32B или пары карт под 70B.
- ASUS RS720-E12-RS8G — 2U, 2 × Xeon 6 (LGA 4710), 32 слота DDR5 — до 4 ТБ памяти под кэш и CXL 2.0 для будущих модулей.
- Supermicro AS-4125GS-TNRT — 4U, 2 × AMD EPYC 9004, 24 слота DDR5, до 8 GPU — платформа для многокарточного сервера вывода.
Рассчитаем сервер под локальную LLM: GPU, память под KV-кэш, диски
Напишите модель и число пользователей — посчитаем объём памяти по формулам из этой статьи, подберём GPU и платформу, проверим совместимость модулей и подготовим КП для юрлица с НДС.
Запросить КП на zakaz@comparema.ruВопросы и ответы
Что такое MARS от SK hynix?
Что такое пул памяти CXL и чем он отличается от обычной DDR5 в сервере?
Откуда цифра «в 5,2 раза быстрее» и можно ли ждать её на своём сервере?
Сколько памяти занимает KV-кэш языковой модели?
Сколько оперативной памяти нужно серверу для локальной LLM?
Что купить сейчас для ИИ-сервера, если CXL-модулей нет в продаже?