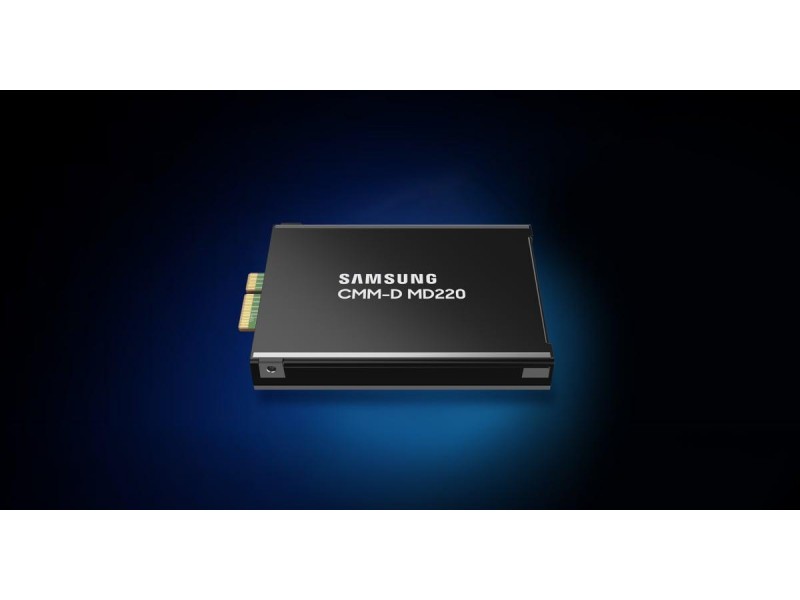
Samsung и AMD продемонстрировали систему, в которой серверы могут динамически использовать общий пул памяти через интерфейс CXL. Технология предназначена, в частности, для ИИ-агентов и больших языковых моделей, которым требуется одновременно обрабатывать множество задач и хранить большие объёмы контекста. По заявлениям Samsung, в демонстрационном сценарии удалось снизить время до появления первого токена (TTFT) до 38% и увеличить пропускную способность по успешно обработанным запросам до 3,3 раза по сравнению со статическим распределением памяти. Результаты предоставлены производителем; независимая проверка в публикации не приводится, полная конфигурация испытательного стенда не раскрыта.
Что именно продемонстрировали Samsung и AMD
В обычной конфигурации каждый сервер получает собственный объём оперативной памяти. Если нагрузка на один узел резко возрастает, свободная память других узлов не всегда может быть использована эффективно. Пул CXL позволяет распределять память между задачами более гибко: AMD предоставила процессоры и платформу, Samsung — память CXL и программное обеспечение для управления пулом.
В демонстрационном сценарии Samsung сравнивала статическое распределение памяти (когда каждый сервер получает фиксированный объём) с динамическим пулом CXL. По данным производителя, время до появления первого токена (TTFT) сократилось до 38%, а пропускная способность по успешно обработанным запросам выросла до 3,3 раза. Эти цифры относятся к конкретному тесту; конфигурация стенда, модель нагрузки и методика измерения не раскрыты.
Что такое CXL простыми словами
CXL (Compute Express Link) — высокоскоростной интерфейс, позволяющий процессорам и совместимым устройствам гибко работать с дополнительной памятью. Он помогает расширять доступную ёмкость без необходимости устанавливать весь объём DRAM непосредственно в каждом сервере. Память становится отдельным масштабируемым ресурсом, который можно выделять разным узлам по мере необходимости.
Важно понимать: CXL не заменяет HBM внутри ускорителей. Он дополняет иерархию памяти, предоставляя дополнительную ёмкость для контекста, промежуточных данных и рабочих наборов ИИ-агентов. Внутри GPU по-прежнему используется HBM, а CXL-пул работает как расширение уровня сервера или стойки.
Почему это важно для ИИ-серверов
- Память становится отдельным масштабируемым ресурсом, а не только компонентом конкретного сервера.
- Сокращаются простои дорогостоящих GPU, если те ждут данные или контекст: память можно перераспределить быстрее.
- Появляется гибкость под агентные нагрузки, где одновременно работают тысячи задач с разными объёмами контекста.
- Упрощается планирование ёмкости: вместо фиксированного объёма на узел можно опираться на общий пул.
- Результаты заявлены производителем. Независимой проверки нет; конфигурация стенда и методика не раскрыты.
- CXL не заменяет HBM. Для инференса больших моделей по-прежнему нужны GPU с HBM; CXL — дополнение, а не альтернатива.
- Нужна поддержка платформы и ПО. CXL-пул требует совместимых процессоров, чипсетов, памяти и операционной системы/гипервизора.
- Задержки. Доступ к удалённой памяти через CXL может быть медленнее, чем к локальной DRAM; для latency-чувствительных задач это важно.
- Экосистема ещё формируется. Не все серверные платформы и приложения готовы к динамическому пулу памяти.
Что это значит для покупателей в России
Официальных поставок Samsung и AMD в Россию нет, но их продукция доступна через параллельный импорт. Однако технология CXL-пула — это не отдельный компонент, а связка «процессор + платформа + память + программное обеспечение». Чтобы её использовать, нужна поддержка на всех уровнях: от серверной платформы до гипервизора и приложений. Поэтому в ближайшее время в российских ЦОД эта конкретная демонстрация вряд ли будет воспроизведена «из коробки».
Практический вывод для проектирования ИИ-кластера: стоит учитывать не только количество DDR5-модулей в каждом узле, но и возможность объединения памяти, поддержку CXL со стороны платформы и программного обеспечения. Если вы планируете агентные нагрузки с большим контекстом, закладывайте запас по памяти и проверяйте, поддерживает ли выбранная платформа CXL-расширение. Для типовых задач — 1С, виртуализации, СУБД и небольшого инференса — по-прежнему достаточно серверов с локальной DDR5.
- HPE ProLiant DL380 Gen12 8SFF (P89316-425-001-000) — шасси 2U под Xeon 6 и DDR5: основа для сборки под конкретную задачу.
- HPE ProLiant DL360 Gen12 8SFF MR408i-o (P89233-425-001-000) — то же поколение в 1U для плотной установки.
- HPE ProLiant DL380 Gen11 Xeon Silver 4410Y, 32 ГБ DDR5, 12 LFF (P52562-B21) — готовая конфигурация для 1С и виртуализации.
- SSD HPE 7,68 ТБ NVMe Read Intensive (P40567-B21) — для баз данных и наборов данных под ИИ.
Соберём сервер под 1С, виртуализацию или инференс, подберём память DDR5, диски и сетевые карты. Для юридических лиц подготовим коммерческое предложение и счёт.
Запросить КП на zakaz@comparema.ru