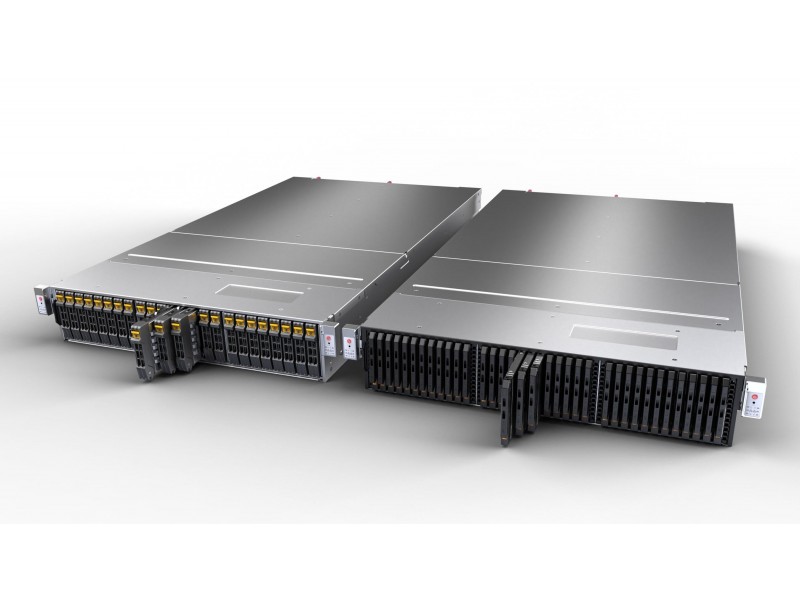
Supermicro 5 ноября 2026 года вместе с IBM и NVIDIA представила готовое решение для хранения KV-кэша — промежуточных данных, которые языковая модель вычисляет, когда читает контекст запроса. Кэш сохраняется на общем флеш-хранилище из серверов Supermicro Petascale и при повторном запросе загружается оттуда, а не считается заново на GPU. В совместном тесте с моделью на 120 млрд параметров время до первого токена на запросе длиной 130 тыс. токенов сократилось до 56 раз: с 32,1 с до 0,57 с. Это результат одного конкретного теста, а не гарантия для любых моделей и нагрузок.
Почему это важно
Прежде чем выдать первое слово ответа, модель читает весь запрос: инструкцию, документы, историю диалога. Для каждого токена она вычисляет пары «ключ — значение» (key-value) в каждом слое — это и есть KV-кэш. Он лежит в памяти GPU, но её мало: у RTX PRO 6000 Blackwell 96 ГБ, и в тесте IBM после загрузки модели на кэш осталось 19,6 ГБ — примерно четыре контекста по 130 тыс. токенов. Когда место кончается, кэш выбрасывается, и при следующем обращении к тому же контексту GPU снова тратит десятки секунд на пересчёт.
Решение Supermicro, IBM и NVIDIA добавляет ещё один уровень памяти — общее хранилище на NVMe. Фреймворк NVIDIA Dynamo выгружает туда рассчитанные блоки кэша, а при повторном запросе (тот же длинный документ, тот же системный промпт агента, продолжение диалога) подгружает их по сети вместо пересчёта. Хранилище общее, поэтому кэш, посчитанный на одном GPU-сервере, может использовать другой.
Что это даёт:
- Время до первого токена почти перестаёт зависеть от длины контекста: в тесте 0,19–0,57 с на запросах от 10 до 130 тыс. токенов.
- GPU не тратит время на повторные вычисления: при 28 одновременных подключениях 200 запросов обработаны за 47 с вместо 1049 с.
- Кэш живёт днями и неделями и не теряется при перезапуске сервиса или GPU-узла.
Ограничения:
- Ускорение есть только для повторяющегося контекста. Новый уникальный запрос всё равно считается на GPU.
- Нужны быстрые NVMe и сеть 200–400 Гбит/с: кэш длинного контекста весит гигабайты (расчёт — ниже).
- Это ещё одна система, которую надо купить, настроить и обслуживать, а IBM Storage Scale — платное ПО.
Из чего состоит решение и как его тестировали
| Компонент | Что использовалось в тесте |
|---|---|
| Узлы хранения | 8 × Supermicro Petascale ASG-1115S-NE316R (1U, 16 отсеков E3.S NVMe) |
| Процессор узла | 1 × AMD EPYC 9535 (64 ядра, поколение 9005 Turin), 128 линий PCIe 5.0: 64 на диски, 64 на сеть |
| Диски | 16 × Micron 7,68 ТБ E3.S на узел — 122,88 ТБ; всего около 983 ТБ «сырой» ёмкости |
| ПО хранилища | IBM Storage Scale Erasure Code Edition 6.0.0.1, схема 8+2P (80% полезной ёмкости), RHEL 9.6 |
| Сеть | 3 коммутатора NVIDIA Spectrum-X SN5600 (spine-leaf, аплинки 800 Гбит/с); в узлах — BlueField-3 2 × 200 Гбит/с к клиентам и ConnectX-7 400 Гбит/с для внутреннего обмена |
| GPU-сервер | Supermicro SYS-212GB-FNR (NVIDIA MGX) с RTX PRO 6000 Blackwell, 2 × BlueField-3 400 Гбит/с; модель работала на одном GPU |
| Модель | openai/gpt-oss-120b, квантование MXFP4 |
| ПО инференса | NVIDIA Dynamo 0.9.0, vLLM 0.14.1, нагрузка — NVIDIA AIPerf |
| Условие теста | кэш в памяти GPU и ОЗУ отключён, весь кэш читался с IBM Storage Scale |
| Внедрение | сборка стоек на заводе Supermicro и монтаж на месте — по заявлению компании, «от недель до дней» |
| Цена | не объявлена |
Источники: IBM Redbook MD260021 «Context Without Limits: A High-Performance KV Cache Platform for Large-Scale AI Inference»; StorageReview, 06.11.2026; пресс-релиз Supermicro, 05.11.2026. Тесты проводили сами IBM, Supermicro и NVIDIA, независимой проверки нет.
Данные IBM Redbook MD260021. В тесте пропускной способности — 100 уникальных промптов, 24 млн токенов и 825 ГБ KV-кэша; результат с кэшем включает первое заполнение кэша. Строка «помехи» — посторонний трафик 200 ГБ/с от четырёх клиентов в той же сети: прирост сократился с 22 до 18 раз.
Кто ещё предлагает хранилища для KV-кэша
| Решение | Как устроено | Опубликованный результат | Статус |
|---|---|---|---|
| Supermicro + IBM + NVIDIA | Petascale на EPYC 9005, IBM Storage Scale ECE, Dynamo, Spectrum-X | TTFT до 56×, пропускная способность 22× (gpt-oss-120b, 130 тыс. токенов) | объявлено 05.11.2026, валидированный дизайн |
| VAST Data | VAST AI OS + Dynamo/NIXL, общий доступ по NFS | TTFT до 20× (тест с CoreWeave); до 9× в тесте с AMD Instinct | доступно |
| WEKA | Augmented Memory Grid на NeuralMesh, GPUDirect Storage | около 300 ГБ/с на хост (заявление WEKA) | доступно |
| NVIDIA CMX | флеш-полки с DPU BlueField-4 в Ethernet-сети, уровень G3.5 | до 5× токенов/с и энергоэффективности против обычных СХД (заявление NVIDIA) | анонсировано; поставки BlueField-4 планировались на 2-е полугодие 2026 |
| LMCache (open source) | подключается к vLLM, хранит кэш в ОЗУ, на дисках или в обычной СХД по TCP/IP | зависит от железа | бесплатно |
Источники: IBM Redbook MD260021; блог VAST Data; StorageReview (VAST и AMD, июль 2026); WWT; Blocks and Files (CES и GTC 2026); Futurum Group. Цифры получены в разных тестах, на разных моделях и железе и напрямую не сравниваются. Об интеграции с Dynamo также заявляли DDN, Dell, HPE, NetApp, Pure Storage и другие производители СХД.
Сколько места занимает KV-кэш: расчёт для популярных моделей
Размер кэша на один токен считается по формуле: 2 × число слоёв × число KV-голов × размер головы × байт на число. Двойка — это ключ и значение, в формате BF16/FP16 на число приходится 2 байта, в FP8 — 1 байт (кэш вдвое меньше). Параметры берутся из файла config.json модели. Для длинного контекста кэш легко превышает десятки гигабайт — поэтому его и выносят из GPU.
| Модель | Слоёв × KV-голов × размер | На 1 токен | Контекст 32 тыс. | Контекст 128 тыс. | 128 тыс. в FP8 |
|---|---|---|---|---|---|
| gpt-oss-120b | 18* × 8 × 64 | 36 КБ | 1,1 ГБ | 4,5 ГБ | 2,3 ГБ |
| Llama 3.1 8B | 32 × 8 × 128 | 128 КБ | 4 ГБ | 16 ГБ | 8 ГБ |
| Llama 3.1 70B | 80 × 8 × 128 | 320 КБ | 10 ГБ | 40 ГБ | 20 ГБ |
| Llama 3.1 405B | 126 × 8 × 128 | 504 КБ | 15,8 ГБ | 63 ГБ | 31,5 ГБ |
Расчёт КомпаРЕМА по параметрам моделей, на один запрос, в двоичных единицах (1 ГБ = 1024 МБ), 128 тыс. = 131 072 токена. * У gpt-oss-120b 36 слоёв, но полное внимание только в 18, остальные смотрят на последние 128 токенов и почти не занимают места. Проверка: в тесте IBM 825 ГБ кэша на 24 млн токенов — около 34 КБ на токен. Модели с другим устройством внимания (например, MLA у DeepSeek) считаются иначе.
Хватит ли сети: сколько секунд грузится кэш
Загрузка кэша из хранилища выгодна, пока она быстрее пересчёта. Время загрузки — это размер кэша, делённый на скорость канала между GPU-сервером и хранилищем:
| Канал до хранилища | Скорость, ГБ/с | gpt-oss-120b, 130 тыс. токенов (4,8 ГБ) | Llama 3.1 70B, 128 тыс. токенов (43 ГБ) |
|---|---|---|---|
| 100 Гбит/с | 12,5 | 0,38 с | 3,4 с |
| 200 Гбит/с | 25 | 0,19 с | 1,7 с |
| 400 Гбит/с | 50 | 0,10 с | 0,86 с |
| 2 × 400 Гбит/с | 100 | 0,05 с | 0,43 с |
Теоретический расчёт по скорости линии, без накладных расходов; размеры кэша здесь в десятичных гигабайтах (1 ГБ = 10⁹ байт). Для сравнения: пересчёт контекста 130 тыс. токенов gpt-oss-120b на одной RTX PRO 6000 в тесте IBM занял 32,1 с. В тесте GPU-сервер был подключён двумя каналами по 400 Гбит/с.
Уровни хранения KV-кэша в NVIDIA Dynamo
| Уровень | Где хранится | Сколько живёт кэш | Доступен другим серверам |
|---|---|---|---|
| G1 | память GPU (HBM, GDDR7) | пока хватает места, доступ за микросекунды | нет |
| G2 | оперативная память сервера | доступ за миллисекунды внутри узла | нет |
| G3 | локальные NVMe SSD сервера | «тёплый» кэш на короткое время | нет |
| G3.5 | флеш-полки NVIDIA CMX на BlueField-4 | минуты и часы | да, в пределах кластера |
| G4 | общая СХД (IBM Storage Scale и др.) | дни, недели, месяцы | да |
Источник: IBM Redbook MD260021. Подробнее о другом способе расширить память под KV-кэш — через память CXL — в нашей новости о XCENA MX1 и SK hynix.
Хронология
Что это значит для покупателей в России
Готовый комплект Supermicro с IBM Storage Scale в Россию официально не поставляется, но саму архитектуру можно повторить из доступных компонентов. NVIDIA Dynamo, vLLM и LMCache — открытое ПО, а вместо Storage Scale можно использовать любое быстрое хранилище на NVMe. При проектировании ИИ-кластера стоит считать не только GPU и их память, но и NVMe-узлы под кэш, сеть 200–400 Гбит/с между ними и то, как часто у ваших пользователей повторяется контекст. Что есть в наличии для такой системы:
- Supermicro AS-5126GS-TNRT — 5U GPU-платформа на двух AMD EPYC 9005/9004, до 8 двухслотовых GPU, в том числе RTX PRO 6000 Server Edition: основа сервера инференса.
- NVIDIA RTX PRO 6000 Blackwell Server Edition 96 ГБ — ускоритель того же семейства, что в тесте: модели до ~120 млрд параметров в 4-битном формате на одной карте.
- ASUS RS700A-E13-RS12U/12NVMe — 1U на двух EPYC 9005 с 12 отсеками NVMe: узел хранилища для кэша.
- Gigabyte R184-S94-AAV1 — 1U с 16 отсеками E3.S NVMe Gen5, как у Petascale в тесте, но на Intel Xeon 6.
- AMD EPYC 9535 — 64 ядра, тот же процессор, что стоит в узлах хранения в тесте.
- Kioxia CD8P-R 7,68 ТБ — U.2 NVMe PCIe 5.0 до 12 000 МБ/с: та же ёмкость, что у дисков в тесте.
- Samsung PM1743 3,84 ТБ — PCIe 5.0 до 14 000 МБ/с: быстрый локальный кэш (уровень G3) в GPU-сервере.
Подберём сервер для ИИ-инференса с быстрым хранилищем
Напишите, какие модели и с какой длиной контекста вы запускаете и сколько пользователей работает одновременно, — рассчитаем GPU, объём NVMe под кэш и сеть и подготовим КП для юрлица с НДС.
- Серверные платформы
- Серверы
- Серверные SSD
- Процессоры для серверов
- Видеокарты и ускорители
- Системы хранения данных
- Сетевое оборудование
- Конфигуратор серверов
Вопросы и ответы
Что такое KV-кэш простыми словами?
Сколько памяти занимает KV-кэш модели на 70 млрд параметров?
Будет ли ускорение в 56 раз на любой модели?
Обязательно ли нужна IBM Storage Scale?
Какая сеть нужна между GPU-сервером и хранилищем кэша?
Что купить сейчас для ИИ-сервера с быстрым хранилищем?


