По мере перехода искусственного интеллекта от экспериментальных проектов к промышленному применению организации сталкиваются с постоянно увеличивающимся объёмом данных. В отличие от вычислительных операций, которые завершаются после выполнения задачи, данные могут продолжать накапливаться годами. Компаниям необходимо хранить исходные наборы данных, результаты обучения, контрольные точки моделей, журналы работы, резервные копии и архивы. В новом исследовании IDC, подготовленном при поддержке Western Digital, приводятся тревожные показатели масштаба этого роста.
Дата публикации: 28 сентября 2026 года | Источник: IDC, при поддержке Western Digital
Ключевые цифры исследования
Почему ИИ создаёт принципиально новую нагрузку на хранилища
Традиционные ИТ-нагрузки, как правило, имеют дело с циклическими процессами: данные обрабатываются, результат фиксируется, а исходные массивы могут быть удалены или заархивированы. ИИ ломает эту логику. Компаниям приходится сохранять:
- исходные наборы данных — для повторного обучения и валидации моделей;
- результаты обучения — промежуточные и финальные веса моделей;
- контрольные точки (checkpoints) — снимки состояния модели на разных этапах;
- журналы работы — данные о запуске, ошибках и метриках;
- резервные копии и архивы — для соблюдения нормативных требований и воспроизводимости.
Всё это накапливается годами и требует постоянного доступа, что радикально меняет требования к инфраструктуре хранения.
Данные исследования IDC
| Показатель | Значение | Период | Комментарий |
|---|---|---|---|
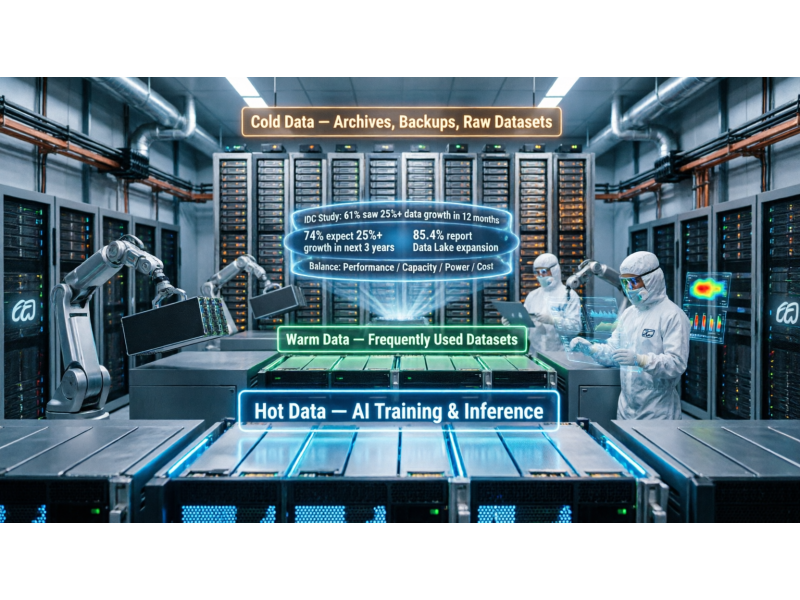
| Организации с ростом данных на 25%+ | 61% | За последние 12 месяцев | Причина — внедрение ИИ |
| Ожидают рост на 25%+ | 74% | В течение 3 лет | Прогноз респондентов |
| Рост объёмов Data Lake | 85,4% | За предыдущий год | Самая высокая доля |
| Ключевая задача | Баланс | Постоянно | Производительность, ёмкость, энергопотребление, стоимость |
Источник: IDC, исследование при поддержке Western Digital (сентябрь 2026).
Прогноз роста объёма данных в организациях
По данным IDC, рост объёма данных ускоряется: если в 2024 году 45% организаций отмечали рост на 25%+, то к 2029 году таких будет уже 80%+.
Что это означает для инфраструктуры хранения
Western Digital подчёркивает, что для масштабирования ИИ необходим баланс между производительностью, ёмкостью, энергопотреблением и стоимостью хранения. Универсального решения нет — нужна многоуровневая архитектура.
| Тип данных | Оптимальный носитель | Обоснование |
|---|---|---|
| Горячие данные, активные рабочие наборы | NVMe SSD | Максимальная скорость, низкая задержка для обучения и инференса |
| Тёплые данные, часто используемые датасеты | SATA/SAS SSD | Баланс скорости и стоимости для регулярного доступа |
| Исходные данные, архивы, резервные копии | HDD | Максимальная ёмкость за минимальную стоимость на терабайт |
| Долгосрочное архивное хранение | Ленточные библиотеки | Минимальная стоимость для холодных данных, соответствует требованиям регуляторов |
Несмотря на развитие SSD, жёсткие диски сохраняют значение для экономичного хранения больших объёмов данных. SSD могут использоваться для горячих данных и активных рабочих наборов, а HDD — для больших массивов исходных данных, архивов и резервных копий. Такое сочетание позволяет достичь оптимального баланса стоимости и производительности на каждом уровне.
Эволюция требований к хранению данных для ИИ
Рост данных под влиянием ИИ — это не временное явление, а структурный сдвиг. Компаниям необходимо пересмотреть архитектуру хранения: где хранить горячие данные для обучения, где — контрольные точки моделей, а где — многолетние архивы. Универсального решения нет: оптимальная стратегия — многоуровневая архитектура с SSD для горячих данных и HDD для архивов. Western Digital и другие производители активно развивают обе линейки, подчёркивая, что баланс между производительностью, ёмкостью, энергопотреблением и стоимостью — ключевая задача на ближайшие годы.